Etwa jede siebte Cloudflare-Website schließt KI-Training per robots.txt aus – die KI-Suche meist nicht
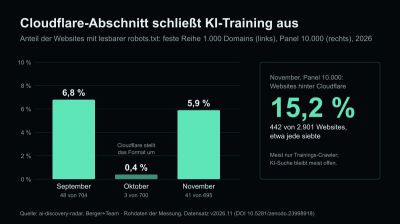
Bei 15,2 Prozent der Websites hinter Cloudflare schließt Cloudflares eigener robots.txt-Abschnitt KI-Training aus, zeigt das offene ai-discovery-radar. Die KI-Suche bleibt meist offen.
Offene Messung des ai-discovery-radar an 10.000 Websites: Gezählt ist der Abschnitt, den Cloudflare selbst in die robots.txt schreibt. In einer festen Reihe von 1.000 Websites liegt der Anteil nach einem Formatwechsel fast wieder auf dem Stand vom September.
Bozen (Südtirol), 18. November 2026 – In der robots.txt, einer kleinen Textdatei auf jeder Website, sagen Betreiber Crawlern, was sie lesen dürfen. Bei 15,2 Prozent der Websites, die diese Datei über den Netzdienst Cloudflare ausliefern, schließt im November 2026 ein Abschnitt, den Cloudflare selbst in die Datei schreibt, das Training von KI-Modellen aus. Bei weiteren 102 dieser Cloudflare-Websites steht nur ein rechtlicher Vorspann von Cloudflare ohne diesen Abschnitt; er enthält selbst keine Regel und ist nicht mitgezählt. Das zeigt das ai-discovery-radar, ein offenes Messprojekt des Bozner Freelancer-Kollektivs Berger+Team, das jeden Monat 10.000 Websites aus internationalen Ranglisten prüft.
Dem Inhalt nach richtet sich der Abschnitt meist nur an das Sammeln von Trainingsdaten. In seiner neuen Form, die im November 439 der 442 Abschnitte mit Trainings-Ausschluss trugen, nennt er Kennungen wie GPTBot, ClaudeBot, CCBot, Google-Extended und Bytespider, die Cloudflare unter “Training crawlers” führt. 420 dieser 439 enthielten nur diesen Teil. 19 schlossen zusätzlich KI-Agenten aus, 6 davon auch die KI-Suche. Die Google-Suche betrifft der Abschnitt nicht; Google-Extended steuert neben dem Training aber auch, ob Gemini-Dienste Inhalte als Grundlage für Antworten nutzen dürfen. Langfristig kann er nach unserer Einschätzung beeinflussen, was KI-Modelle ohne Websuche über einen Betrieb wissen.
Über drei Monate ist der Ausschluss nicht gewachsen, sondern zurückgekehrt. Das zeigt eine feste Reihe von 1.000 Websites, die das Radar jeden Monat gleich misst: Im September schloss Cloudflares Abschnitt dort bei 6,8 Prozent der Websites das Training aus, im Oktober bei 0,4 Prozent, im November bei 5,9 Prozent (95-%-Intervalle 5,2-8,9, 0,1-1,3 und 4,4-7,9 Prozent). Der Rückgang im Oktober passt zu Cloudflares Ankündigung, die alte Form des Abschnitts zum 15. September abzulösen. Die neue Form unterscheidet nach Training, KI-Suche und KI-Agenten. Ohne Cloudflares Abschnitt schließen im großen Panel weitere 826 Websites Trainings-Crawler mit eigenen Zeilen aus, ein Teil davon, indem sie alle Crawler aussperren. Das sind mehr als über den Abschnitt.
“Die robots.txt ist die Hausordnung einer Website für Maschinen, und bei vielen hat sie jemand anderes geschrieben”, sagt Florian Berger, Gründer von Berger+Team. “Ob ein Betreiber den Ausschluss von KI-Training bewusst gesetzt hat oder ob er als Voreinstellung kam, sieht man der Datei nicht an. Wer sie fünf Minuten lang liest, entscheidet selbst, welche KI-Dienste er hereinbittet.”
Prüfen lässt sich das in zwei Schritten: die eigene Adresse mit /robots.txt am Ende im Browser öffnen und nach der Zeile “# BEGIN Cloudflare Managed content” suchen. Steht zwischen dieser Zeile und “# END Cloudflare Managed Content” “User-agent: GPTBot” mit “Disallow: /” oder “# Training crawlers”, schließt der Abschnitt KI-Training aus. Stehen dort auch “# AI Agents” oder “# AI Search crawlers”, schließt die Datei auch KI-Agenten oder die KI-Suche aus. Eine robots.txt ist eine Bitte an Crawler, keine technische Sperre.
Zur Messung: Das ai-discovery-radar misst seit August eine feste Reihe von 1.000 Domains aus internationalen Ranglisten beliebter Websites und hat das Panel seit Oktober auf 10.000 Domains erweitert. Gemessen wurde vom 1. bis 3. September, vom 1. bis 5. Oktober und vom 1. bis 5. November 2026. Gezählt sind Websites mit lesbarer robots.txt: im November 6.951 im großen Panel und 695 in der festen Reihe. Von den 6.951 liefern 2.901 die Datei über Cloudflare aus, das sind gut zwei von fünf; bei 442 davon schließt Cloudflares Abschnitt das Training aus, 15,2 Prozent (95-%-Intervall 14,0-16,6). Über alle 6.951 Websites gerechnet sind es 6,4 Prozent. Als Ausschluss gezählt ist ein Abschnitt, der GPTBot sperrt oder das Signal ai-train=no setzt. Das Radar erkennt Cloudflare an dessen Kopfzeilen in der Antwort der Website. Die Domains sind keine Zufallsstichprobe des Webs. Ob sich ein Crawler an die robots.txt hält, misst das Radar nicht. Die monatlichen Anteile je Datei sind offen im Datensatz v2026.11 (DOI 10.5281/zenodo.23998918); die Cloudflare-Zahlen sind aus den Rohdaten der Messung ausgezählt und stehen im Beitrag.
Ausführliche Auswertung mit Anleitung: https://btlabs.dev/de/posts/radar-november-2026-cloudflare
Datensatz: https://doi.org/10.5281/zenodo.23998918
Verantwortlicher für diese Pressemitteilung:
Berger+Team
Herr Florian Berger
Reichrieglerweg 17/3
39100 Bozen
Italien
fon ..: +39 346 103 3556
web ..: https://www.berger.team
email : info@berger.team
Berger+Team ist ein Freelancer-Kollektiv aus Bozen (Südtirol) für Branding, Webdesign, Online-Marketing und KI-Sichtbarkeit, 2019 gegründet von Florian Berger. Mit btlabs Core hat das Kollektiv eine eigene mehrsprachige Website-Plattform entwickelt, die Inhalte für Menschen und KI-Dienste gleichermaßen lesbar aufbereitet. Das ai-discovery-radar ist ein offenes Messprojekt des Kollektivs: Es misst monatlich, wie verbreitet maschinenlesbare Dateien im Web sind, und veröffentlicht die Daten.
Pressekontakt:
Berger+Team
Herr Florian Berger
Reichrieglerweg 17/3
39100 Bozen
fon ..: +39 346 103 3556
email : info@berger.team
AchtungFür den Inhalt des Artikels ist der jeweilige Autor und nicht der Seitenbetreiber verantwortlich. |